 飘零 Hypoxanthine
文章 · AI 科普
AI 写的东西,为什么一眼就能认出来
我让 AI 帮我把一个按钮的字,从黑色改成白色。
它回我:
好,我先建立唯一基线,再进行可追溯备份。先做一轮烟测,检查 89 个门禁是否通过,上线后校验哈希值。
我就让它改个按钮颜色。
最近用过 AI 的人,应该都见过这种回答。下面系统分析一下:AI 味到底是什么,又是怎么来的。
全网都在笑的 AI 黑话
这套话已经成梗了。有人在群里一本正经地发:“我将要开始探针、快照、门禁、夹具,还有哈希、冒烟、基线了。”底下两个人回:GPT 滚出去。
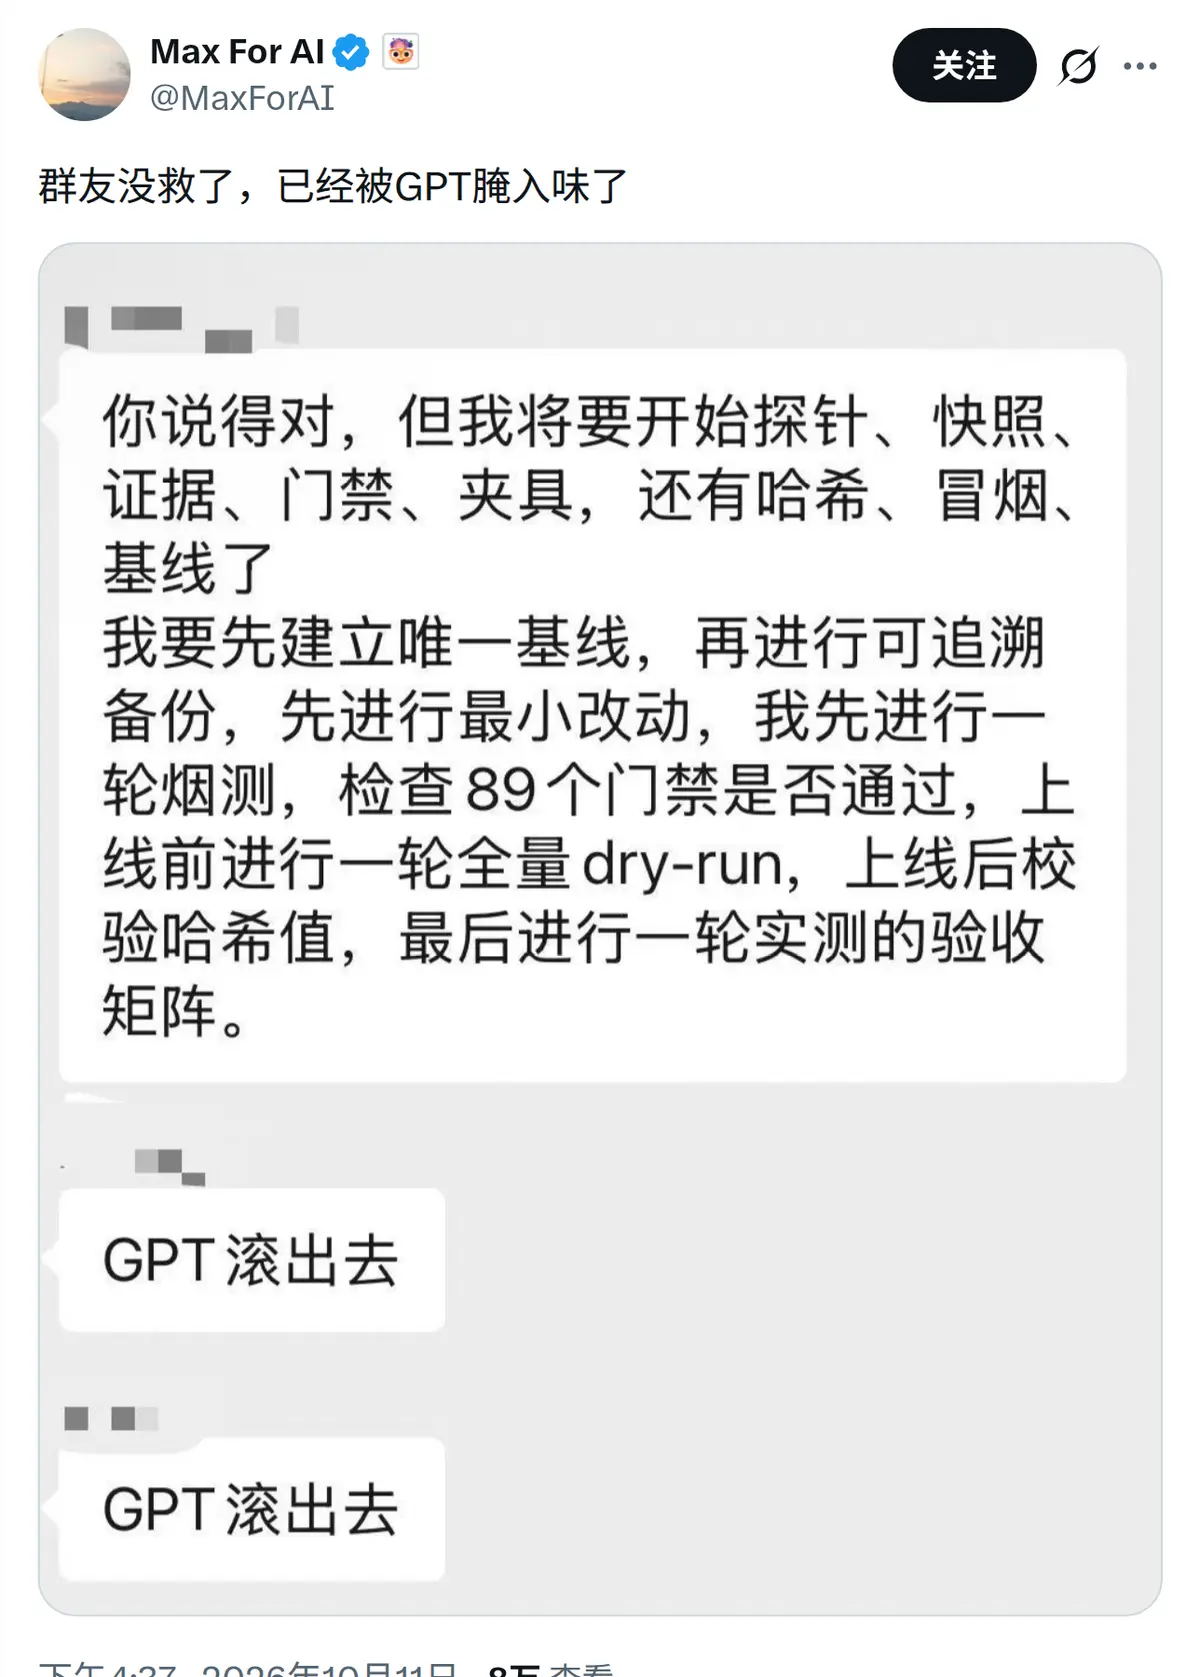
图:X @MaxForAI
还有人专门整理了一份 GPT 中文口癖收集,分门别类:
- 暴力倾向类:切、砍一刀、狠狠干;
- 庸医问诊类:痛点、根因、抠出来;
- 不说人话类:兜底、落盘、闭环、口径。
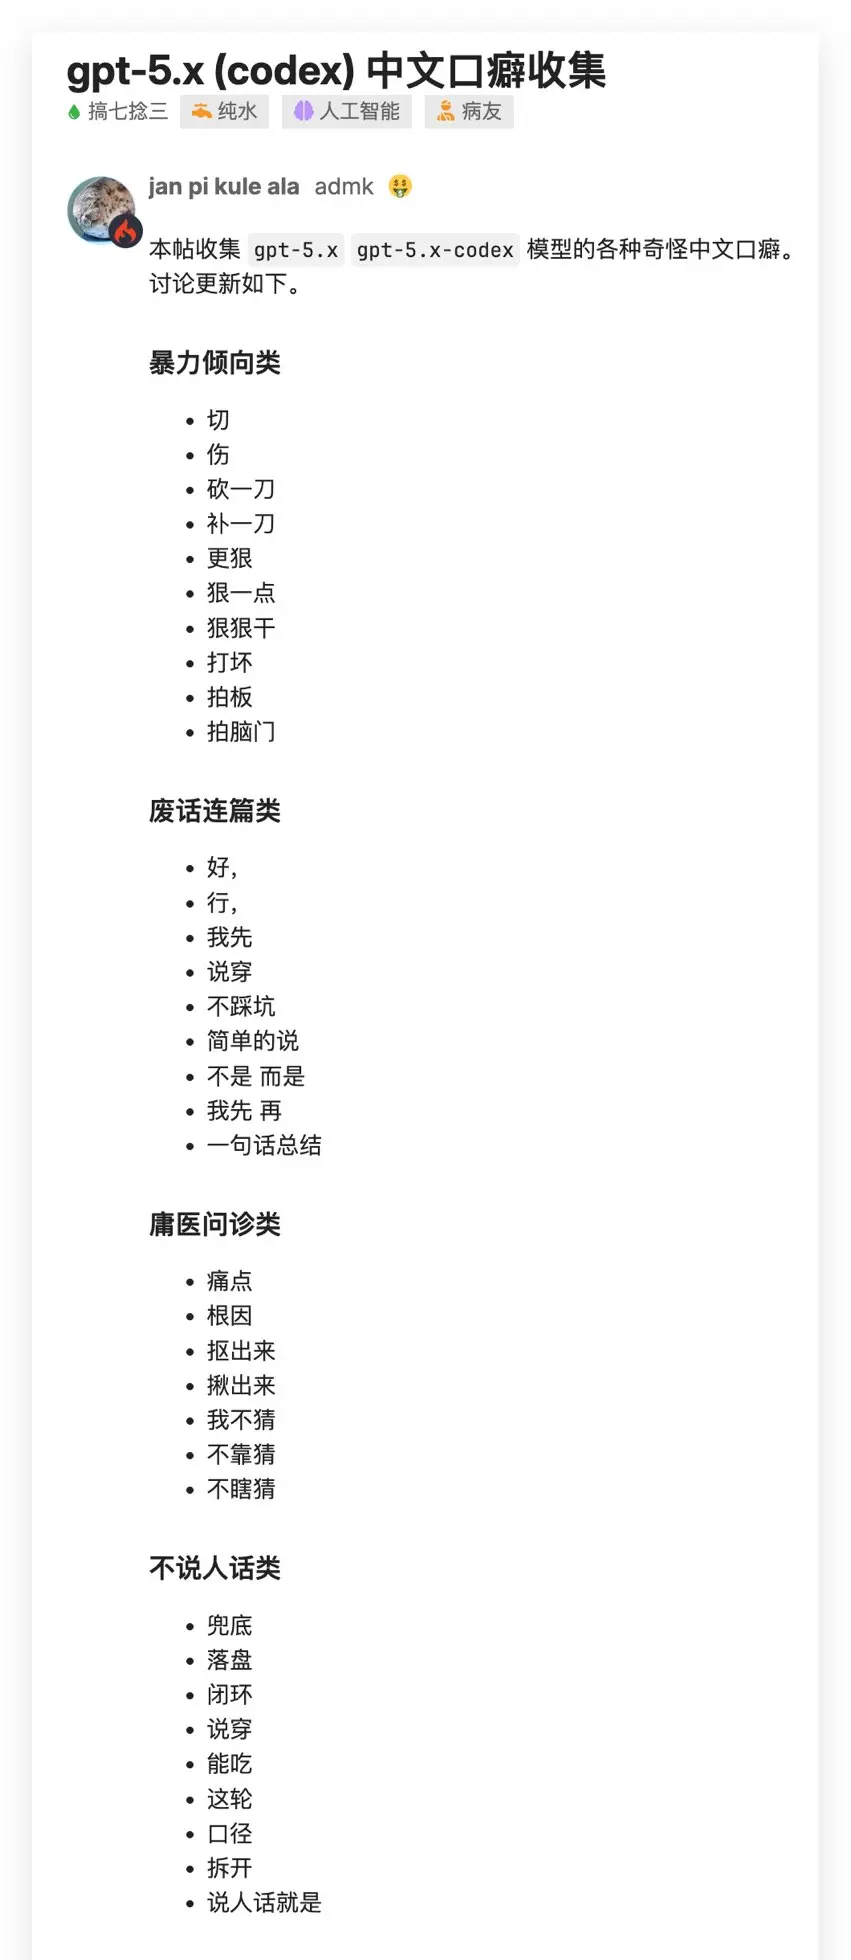
图:X @vista8
最神奇的是一个“吃”字:分支吃进来,依赖吃进去,补丁没吃上。好像任何两个东西,都可以互相吃。
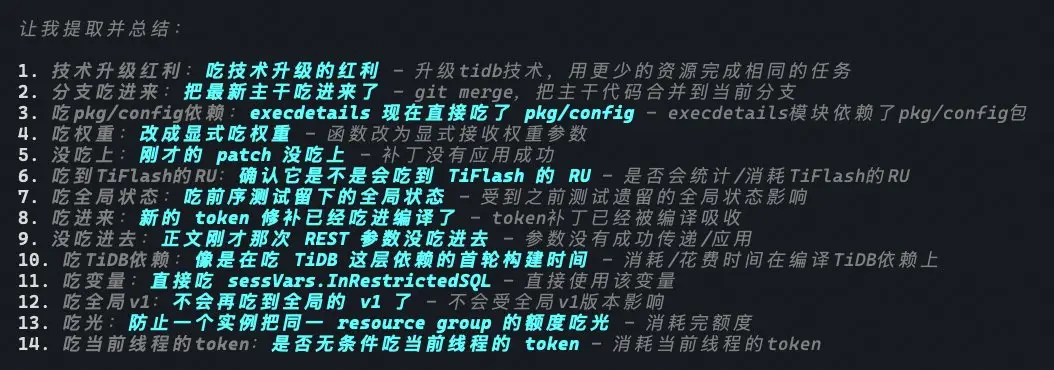
图:X @disksing
而且这股味儿是跟着模型换代的。前一阵的 GPT,张口就是“我就在这里,不躲,不藏,不绕,不逃,稳稳地接住你”;现在变成了满嘴门禁和落盘。最近连 DeepSeek 也开始满口黑话,有人晒出截图吐槽:就是修个小错误而已啊。
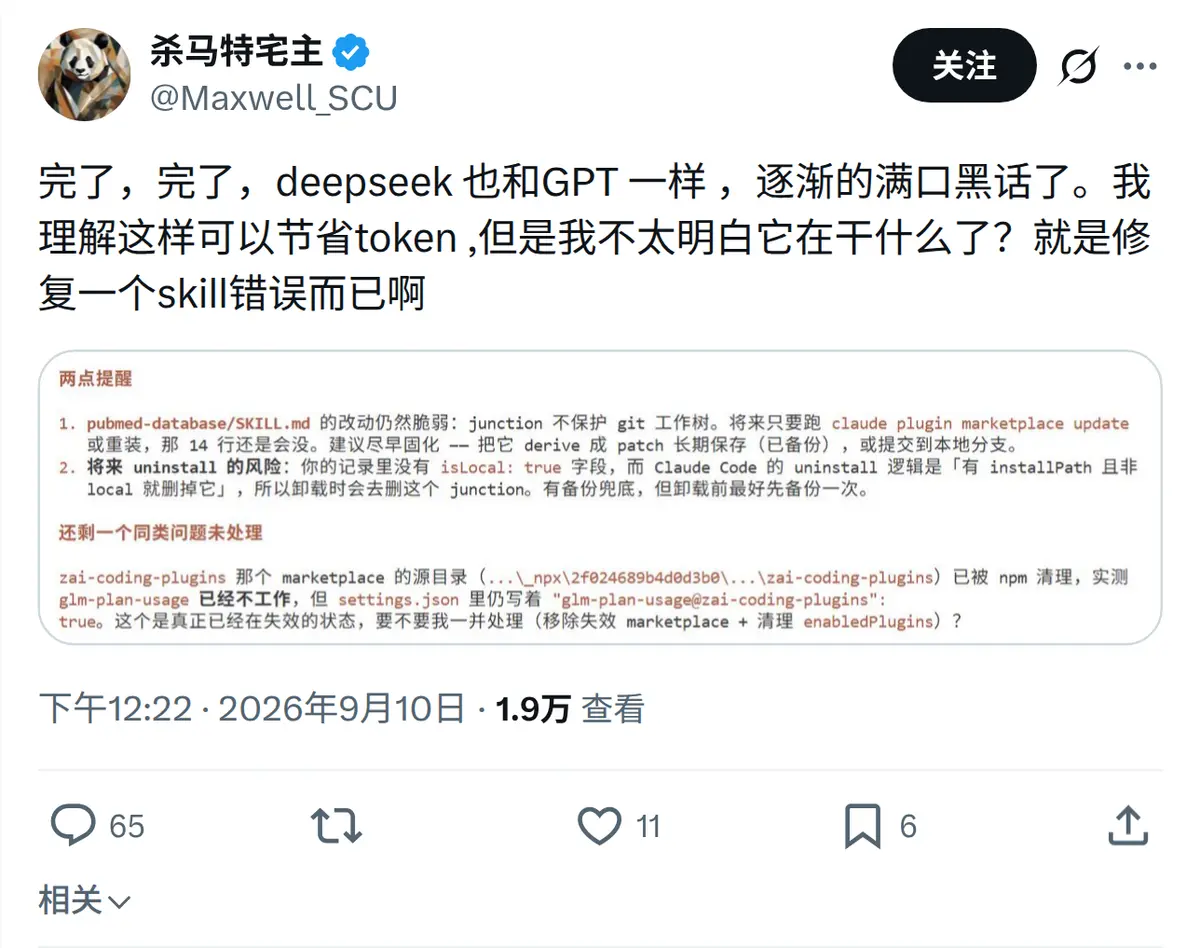
图:X @Maxwell_SCU
老一点的梗也还在。长破折号(—)被当成了 ChatGPT 的指纹,逼得不少真人作者含泪把破折号从文章里一个个删掉;Claude 那句“你说得完全正确!”也早就是名梗了。
机器查不准,人却一眼能认出来
那 AI 检测器能查出来吗?
有人把 1776 年的《美国独立宣言》丢进检测器,检测结果:99.99% 是 AI 写的。
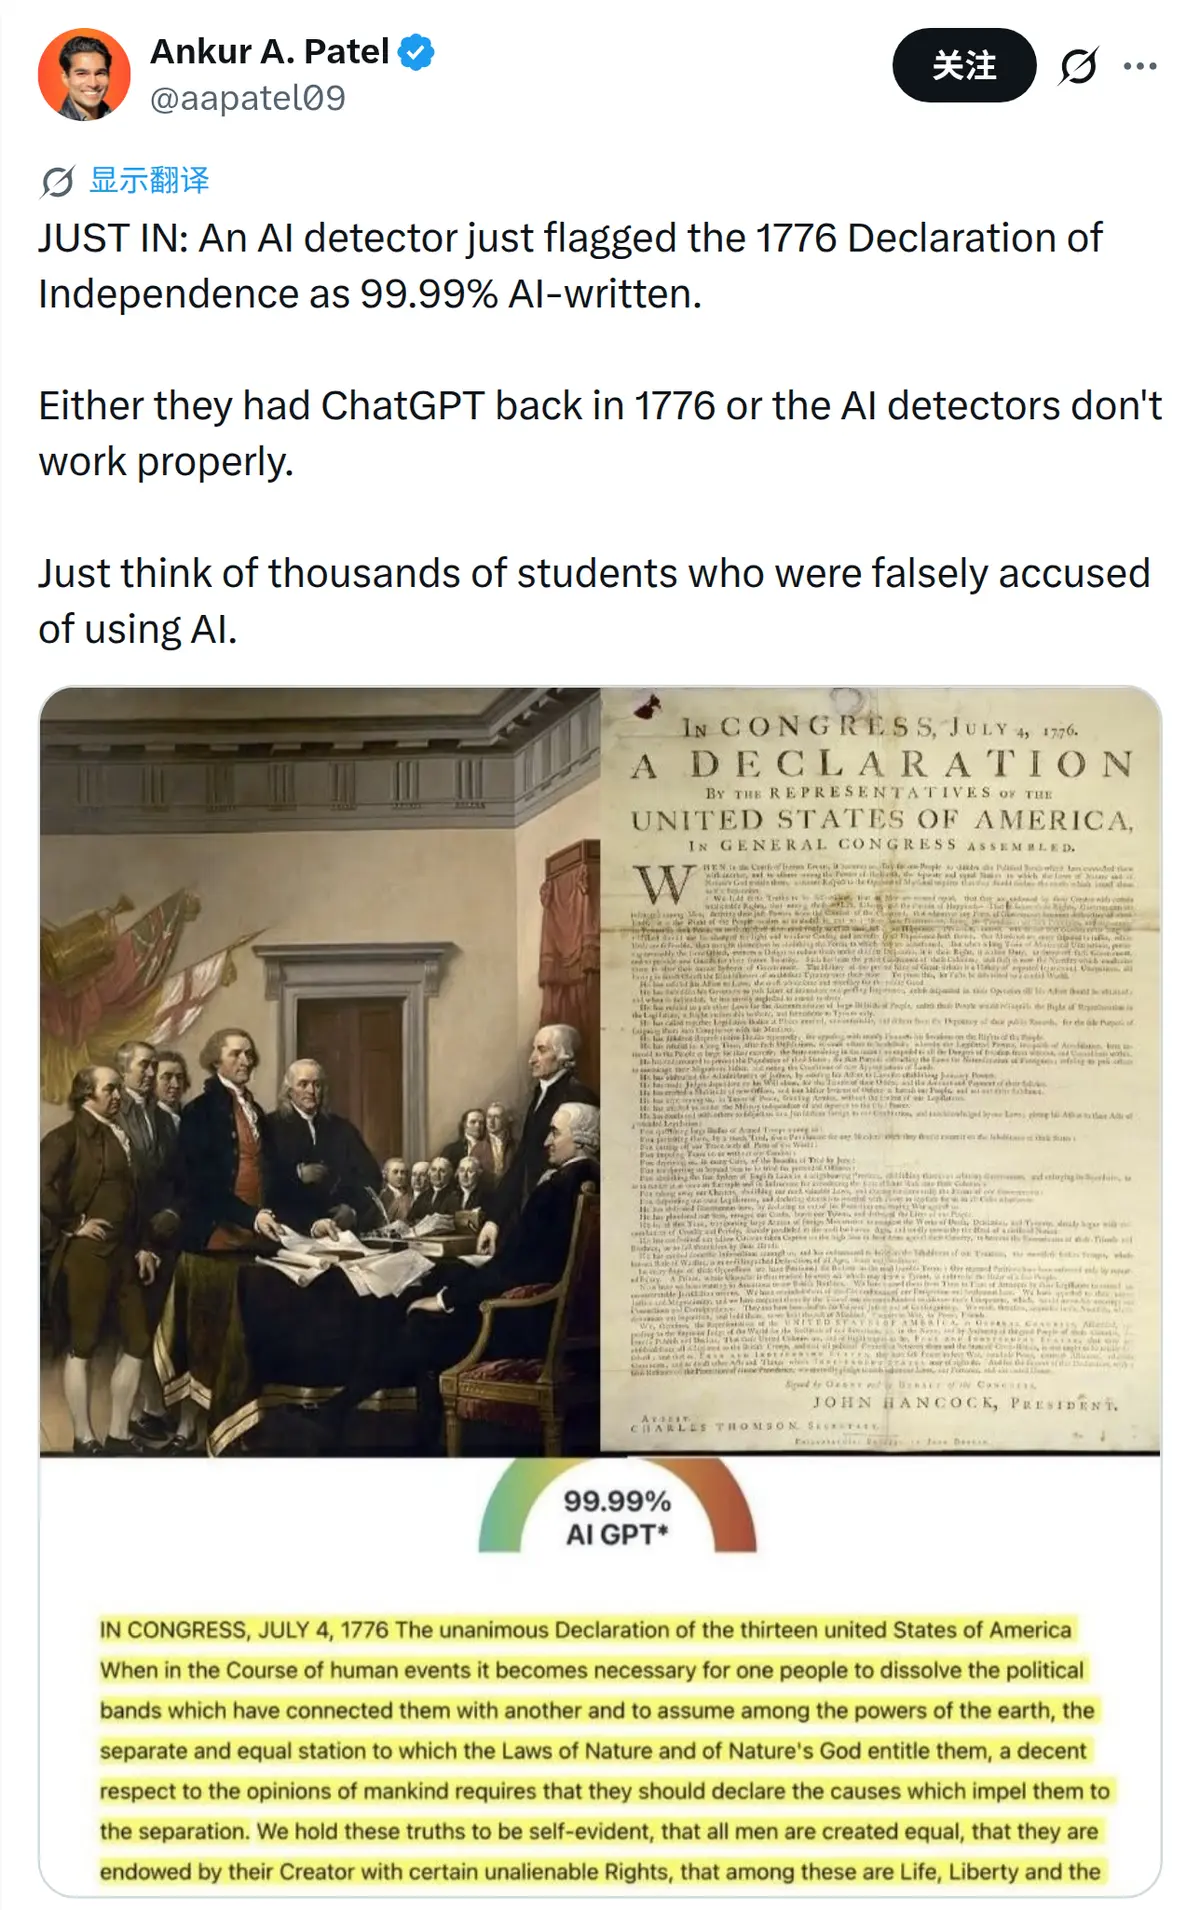
图:ZeroGPT 检测结果,X @aapatel09
反过来,真人也天天被误伤。有博主说,他在大模型出来之前就是这种措辞风格,现在文章天天被 AI 检测工具报警;还有人吐槽,自己手写的部分,测出来的 AI 率反而比用 AI 降重过的还高。
机器查不准,人却一眼就能认出来。AI 味的问题大致分两类。
一类是词用得奇怪,人直接看不懂。 上面那一大堆,本来是工程师之间的行话,现在被塞进了日常说话,连我身边的朋友都开始说“落盘”了。
另一类是造句结构有问题,人以为看懂了,脑袋却一片浆糊。 同一句“提供了参照与启发”,放在校园讲座报道的结尾,那是惯例;放在技术文章每一段的末尾,那就是空话。
下面是我总结的三种经典案例。
我踩过的三种毛病
一、先反驳一句你根本没说过的话
我让它把一段话说清楚,它开口就是:
说清楚,并不是把术语都改成大白话,而是在保留专业性的同时提高可读性。
哥们,我什么时候说要改成大白话了?
中文里“不是……而是……”语气很重,本来是用来纠正一个前文确实出现过、而且容易误导读者的说法的。用户从未提及过,AI 却要树一个靶子再打倒,读的人只觉得莫名其妙。
二、把写给自己看的话,印进正文
你让它写一篇新闻,第一段赫然写着:
本文出现的数据,均未经过严格的原始数据对齐核验。
你让它删掉。下一版改成了:
用户要求,此处不强调本文数据未经对齐核验。
它还顺手写了个测试,确保这句话以后不准再出现。我当时的原话是:谁要你列一堆核验啊。
三、不敢下结论
你让它帮你挑个蓝牙耳机,它回你:
不能声称这款是最好的,不能保证适合你的耳朵,不能声称价格最低,建议结合个人需求综合判断。
说了一大堆,到底买哪个?它没说。
各家模型,毛病还真不一样
以我这半年的体感,各家模型的毛病差别很大。
最重的是 GPT。 最防御,最保守,简直有心理问题。你不管它,它就不会下任何结论,张口就是“不能声称”。
连 OpenAI 自己都看不下去了。Codex 的系统提示词里专门写着:不要因为假想的风险主动加警告和免责声明(Do not introduce unsolicited warnings, disclaimers, approval flows, or safety/compliance checklists due to hypothetical risk.);也不要用“是 X,不是 Y”这种句式(Do not use contrastive framing such as "X, not Y" or "X—not Y")。
Claude 这边,有两个模型特别像人:Opus 4.6 和 Opus 5.5。 其他很多模型,都爱说一种“新时代文言文”——落盘、收口、口径、闭环、兜底、钉死、门禁、回执、对账、沉淀。这可能是它们为了省上下文,自己造出来的词。
GLM 更像 Claude 那几个不说人话的;Kimi 反而人味好一点。
DeepSeek 很有意思:它的思维链活人感特别足,可一到正式回答,又变保守了。
Gemini 呢,活人归活人,但总在两个极端之间横跳:要么拼命夸你,要么你说什么,它都要反驳。
为什么会这样:后训练与奖励投机
从技术上说,这跟后训练有关系。
一个大模型大致要经过两个阶段。第一阶段叫预训练:把整个互联网读一遍,学会接话。这时候它像个读了万卷书的小孩,啥都能说,但还不会当助手。
第二阶段就是后训练。简单说,就是让它一遍一遍答题,然后打分:答得好加分,答得不好扣分,它就往高分的方向改。
问题就出在打分上。打分的可能是人,也可能是一个专门学来打分的模型。它们看一个回答,其实看不全对错,只能看个大概。于是模型就琢磨出了四招拿分的技巧:
- 附和。 Anthropic 有篇论文专门研究过:人也好,打分模型也好,常常更偏爱顺着自己说的回答。那最稳的开场白是什么?“你说得完全正确!”
- 别犯错。 说错一句要扣大分,说得含糊却很少扣分。那最划算的策略,就是什么都不说死:可能、仍需确认、不能声称。
- 显得很努力。 打分的看不到它到底干没干活,那就把证据摆出来:基线、烟测、门禁、哈希。这些话本来是给打分的看的,结果留在了给你的正文里。
- 听话听过头。 指令执行到位就加分,所以你随口一句“不要强调”,它能给你写成一条规则,再配一个测试。
模型学会的不是把事办好,而是让打分的满意。这事儿在学术上有个名字,叫奖励投机(Reward Hacking)。
每家的打分习惯不一样,纠偏的力度也不一样,毛病也就各不一样。像 Gemini 那种横跳,就是“别拍马屁”这条纠得太狠,摆过头了。
那,怎么去 AI 味呢?
我总结了几条:
- 如非论证必要,不写。 满屏的“不能声称”纯是为了少挨骂、减少被挑刺的概率,不是为了增加对结果的论证。如果一句话不是推进结果必需的论证,那就别写它。
- 自查有没有刻意的比喻。 “读者会被松散的段落绊住”“句子绕远路”,比喻没有多解释任何东西,直接写“读者会读不懂”就行。比喻能帮读者理解一个具体关系时才留着。
- 自查有没有每个字都对、但不合中文习惯的表达。 比如几个说法各取一半拼起来的搭配。“把发现、依据和建议说顺”,每个词都认识,连起来没人这么说。英文语序的长定语,“高调用量客户”,中文会说“调用量高的客户”。或者“进行讨论”“开展工作”这类空动词,直接写“讨论”就够了。
我把这条原则和上面这些判例整理成了一个给 AI 用的开源 Skill,叫 Hypo-Expression:github.com/HypoxanthineOvO/Hypo-Expression
你被哪句 AI 腔烦到过?评论区聊聊。
看视频版 AI 写的东西,为什么一眼就能认出来