 飘零 Hypoxanthine
文章 · AI 去水
实锤!祖冲之蒸馏了 Claude
而圆周率蒸馏了 GPT。两个结论出自同一个模型指纹工具,就是那个“测出” DeepSeek 新模型是 GPT-6 Astra 换皮的工具。
破案了。祖冲之是蒸馏 Claude 搞出来的。
证据就摆在眼前,抵赖没用。我把祖冲之在公元五世纪算出来的密率 355/113,按小数位拆开,直接塞进这两天全网疯传的模型指纹鉴定工具 ModelTrace。
鉴定结果当场出炉:77.5% 的概率是 Claude Opus 5.5,Claude 家族归属度 100.0%。
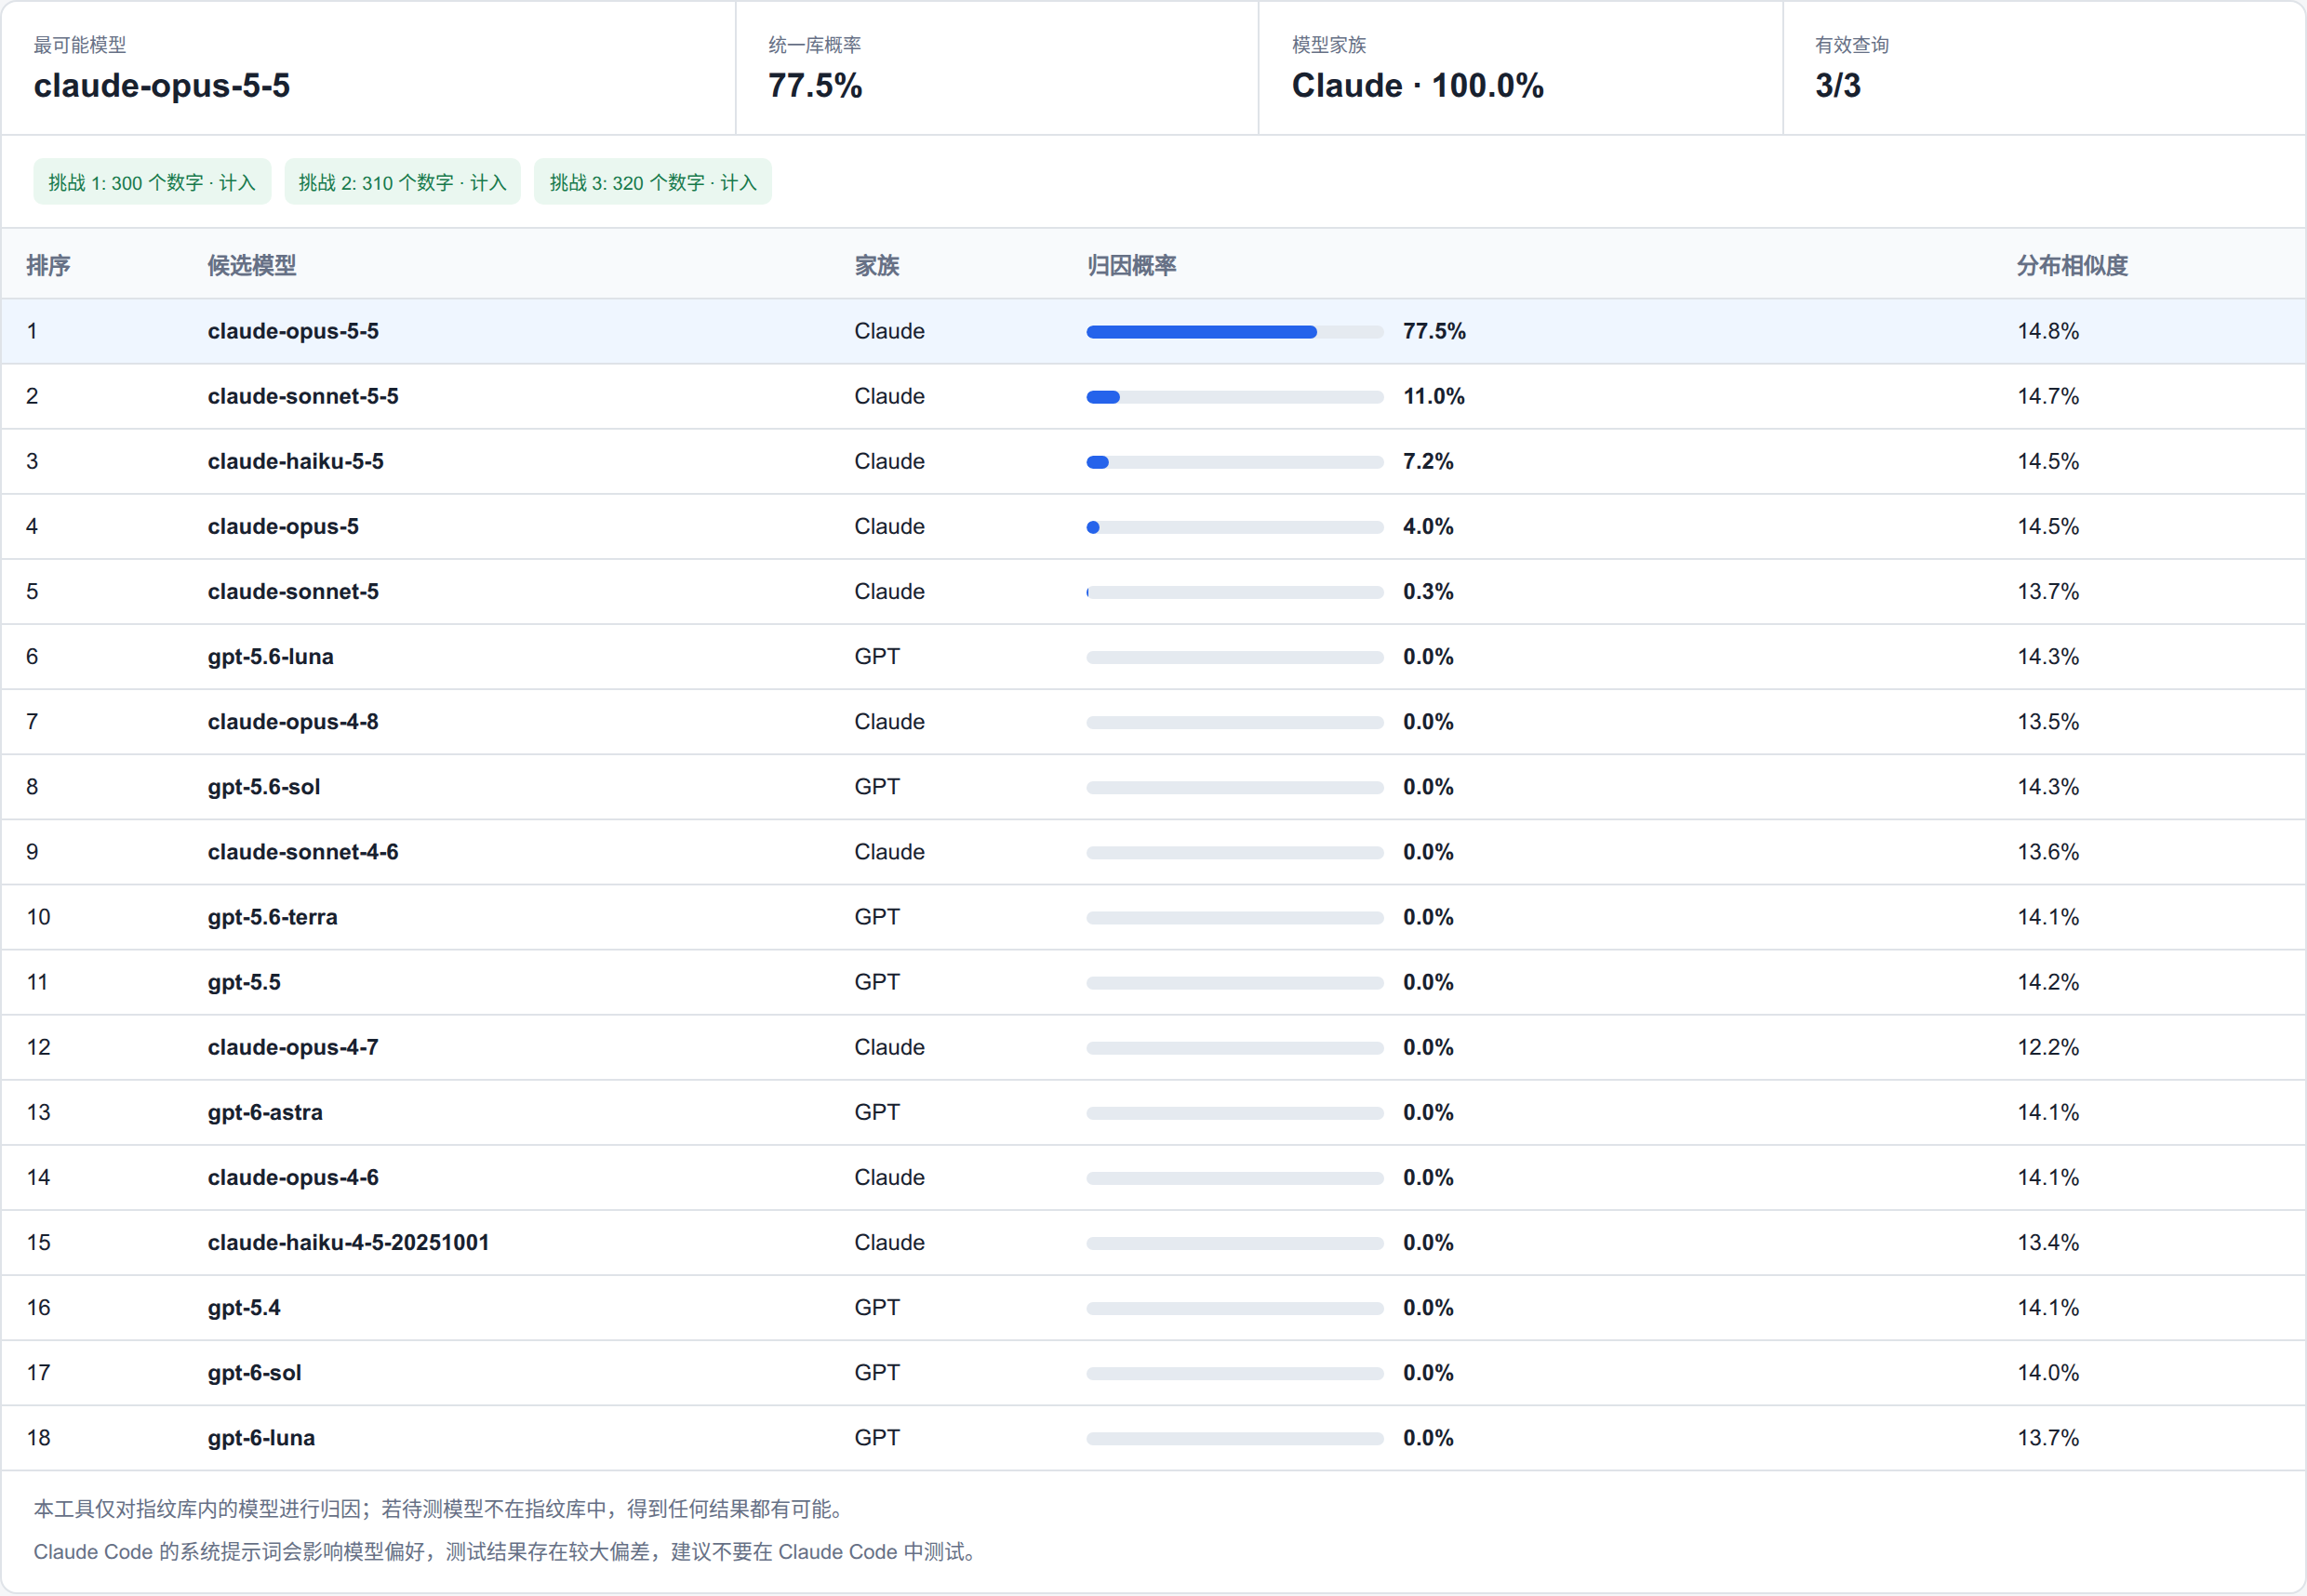
图:355/113 的小数位在 ModelTrace 网页版上的归因结果
历史书可以改写了。什么《缀术》,什么割圆术,全是假的。真相是祖冲之趁夜深人静,偷偷摸进旧金山的数据中心,对着 Anthropic 2026 年才发布的旗舰模型猛薅 API,把结果抄回了南北朝。建议 Anthropic 法务部立刻启动跨时空维权,查查自家的服务条款管不管得到南朝宋孝武帝大明年间。
你以为只有祖冲之在蒸?顺着查下去,我发现了一场横跨古今的大规模蒸馏案。
祖冲之算了一辈子的圆周率 π,叛变了师门。我把 π 的小数位同样切开丢进去,鉴定结果:87.7% 是 GPT-5.6 Sol,GPT 家族归属度 100.0%。
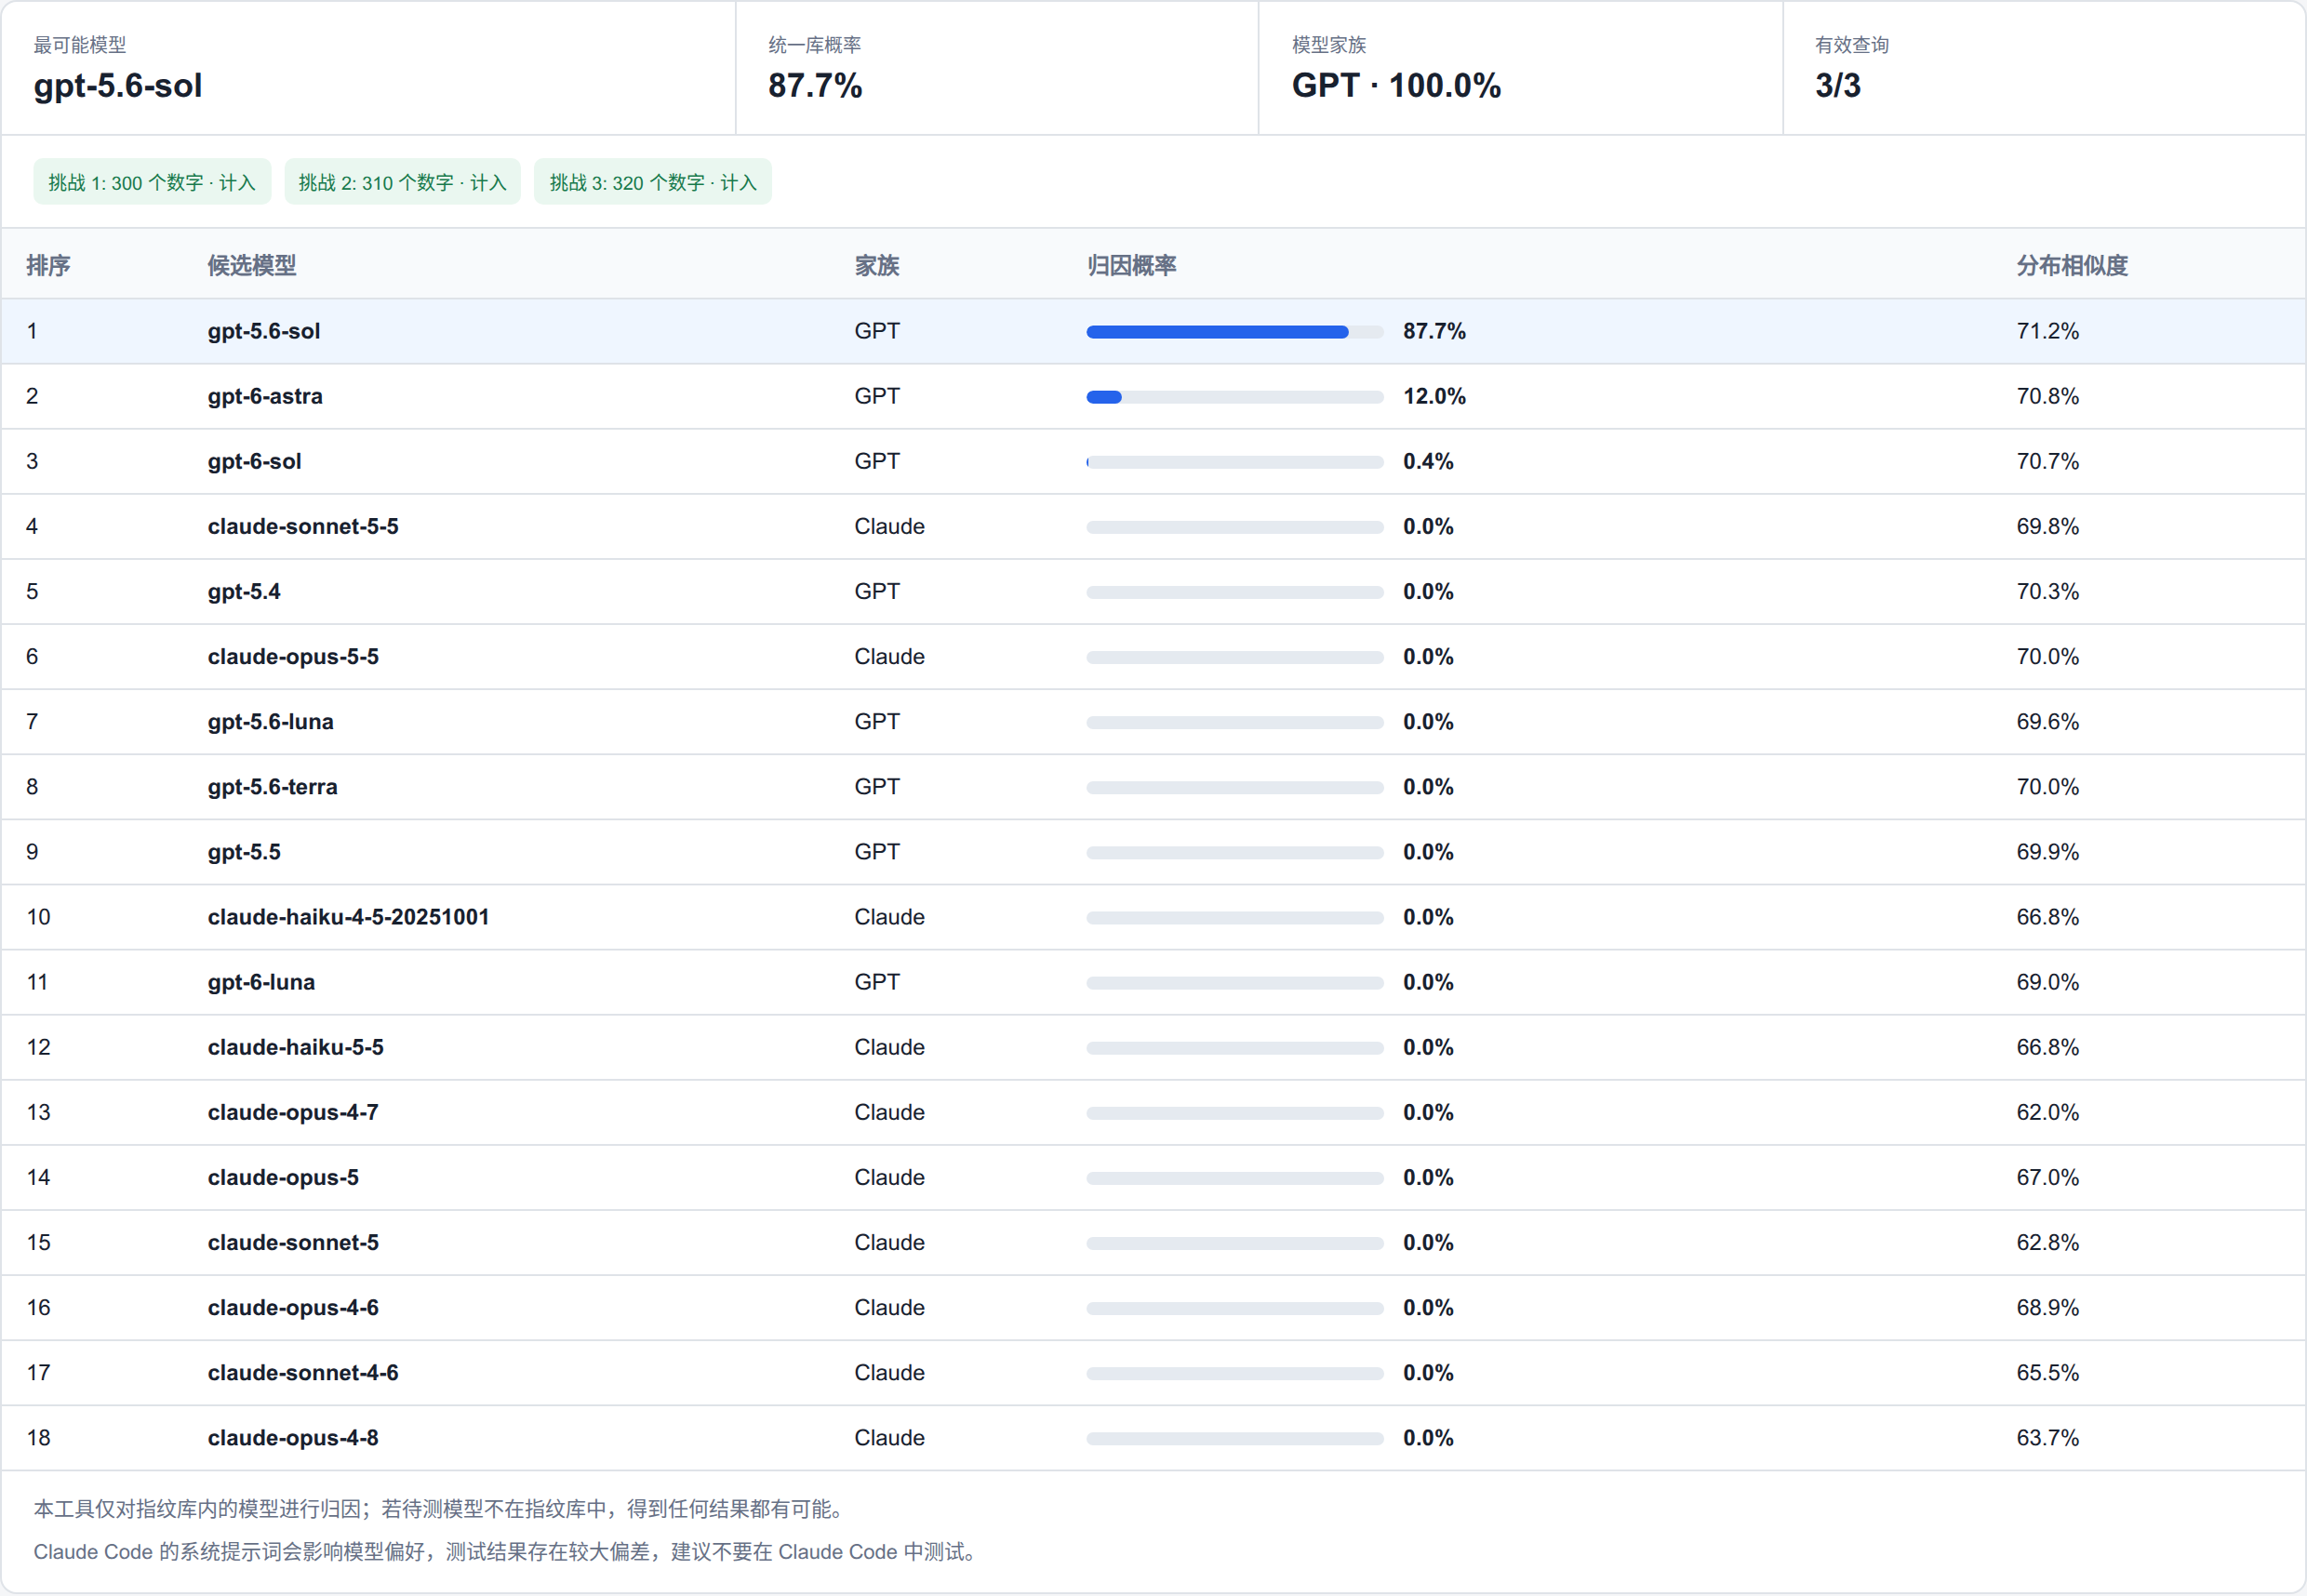
图:π 的小数位在 ModelTrace 网页版上的归因结果
一个人和他算了一辈子的数,当场分家:祖冲之投了 Anthropic,圆周率归了 OpenAI。数学常数尚且在硅谷两巨头之间反复横跳,可见形势有多严峻。
再往下查,连程序员吃饭的家伙也沦陷了。Python 标准库自带的 random 模块,无数人每天都在调的伪随机数生成器,丢进去一测:99.94% 是 Claude Opus 5.5。
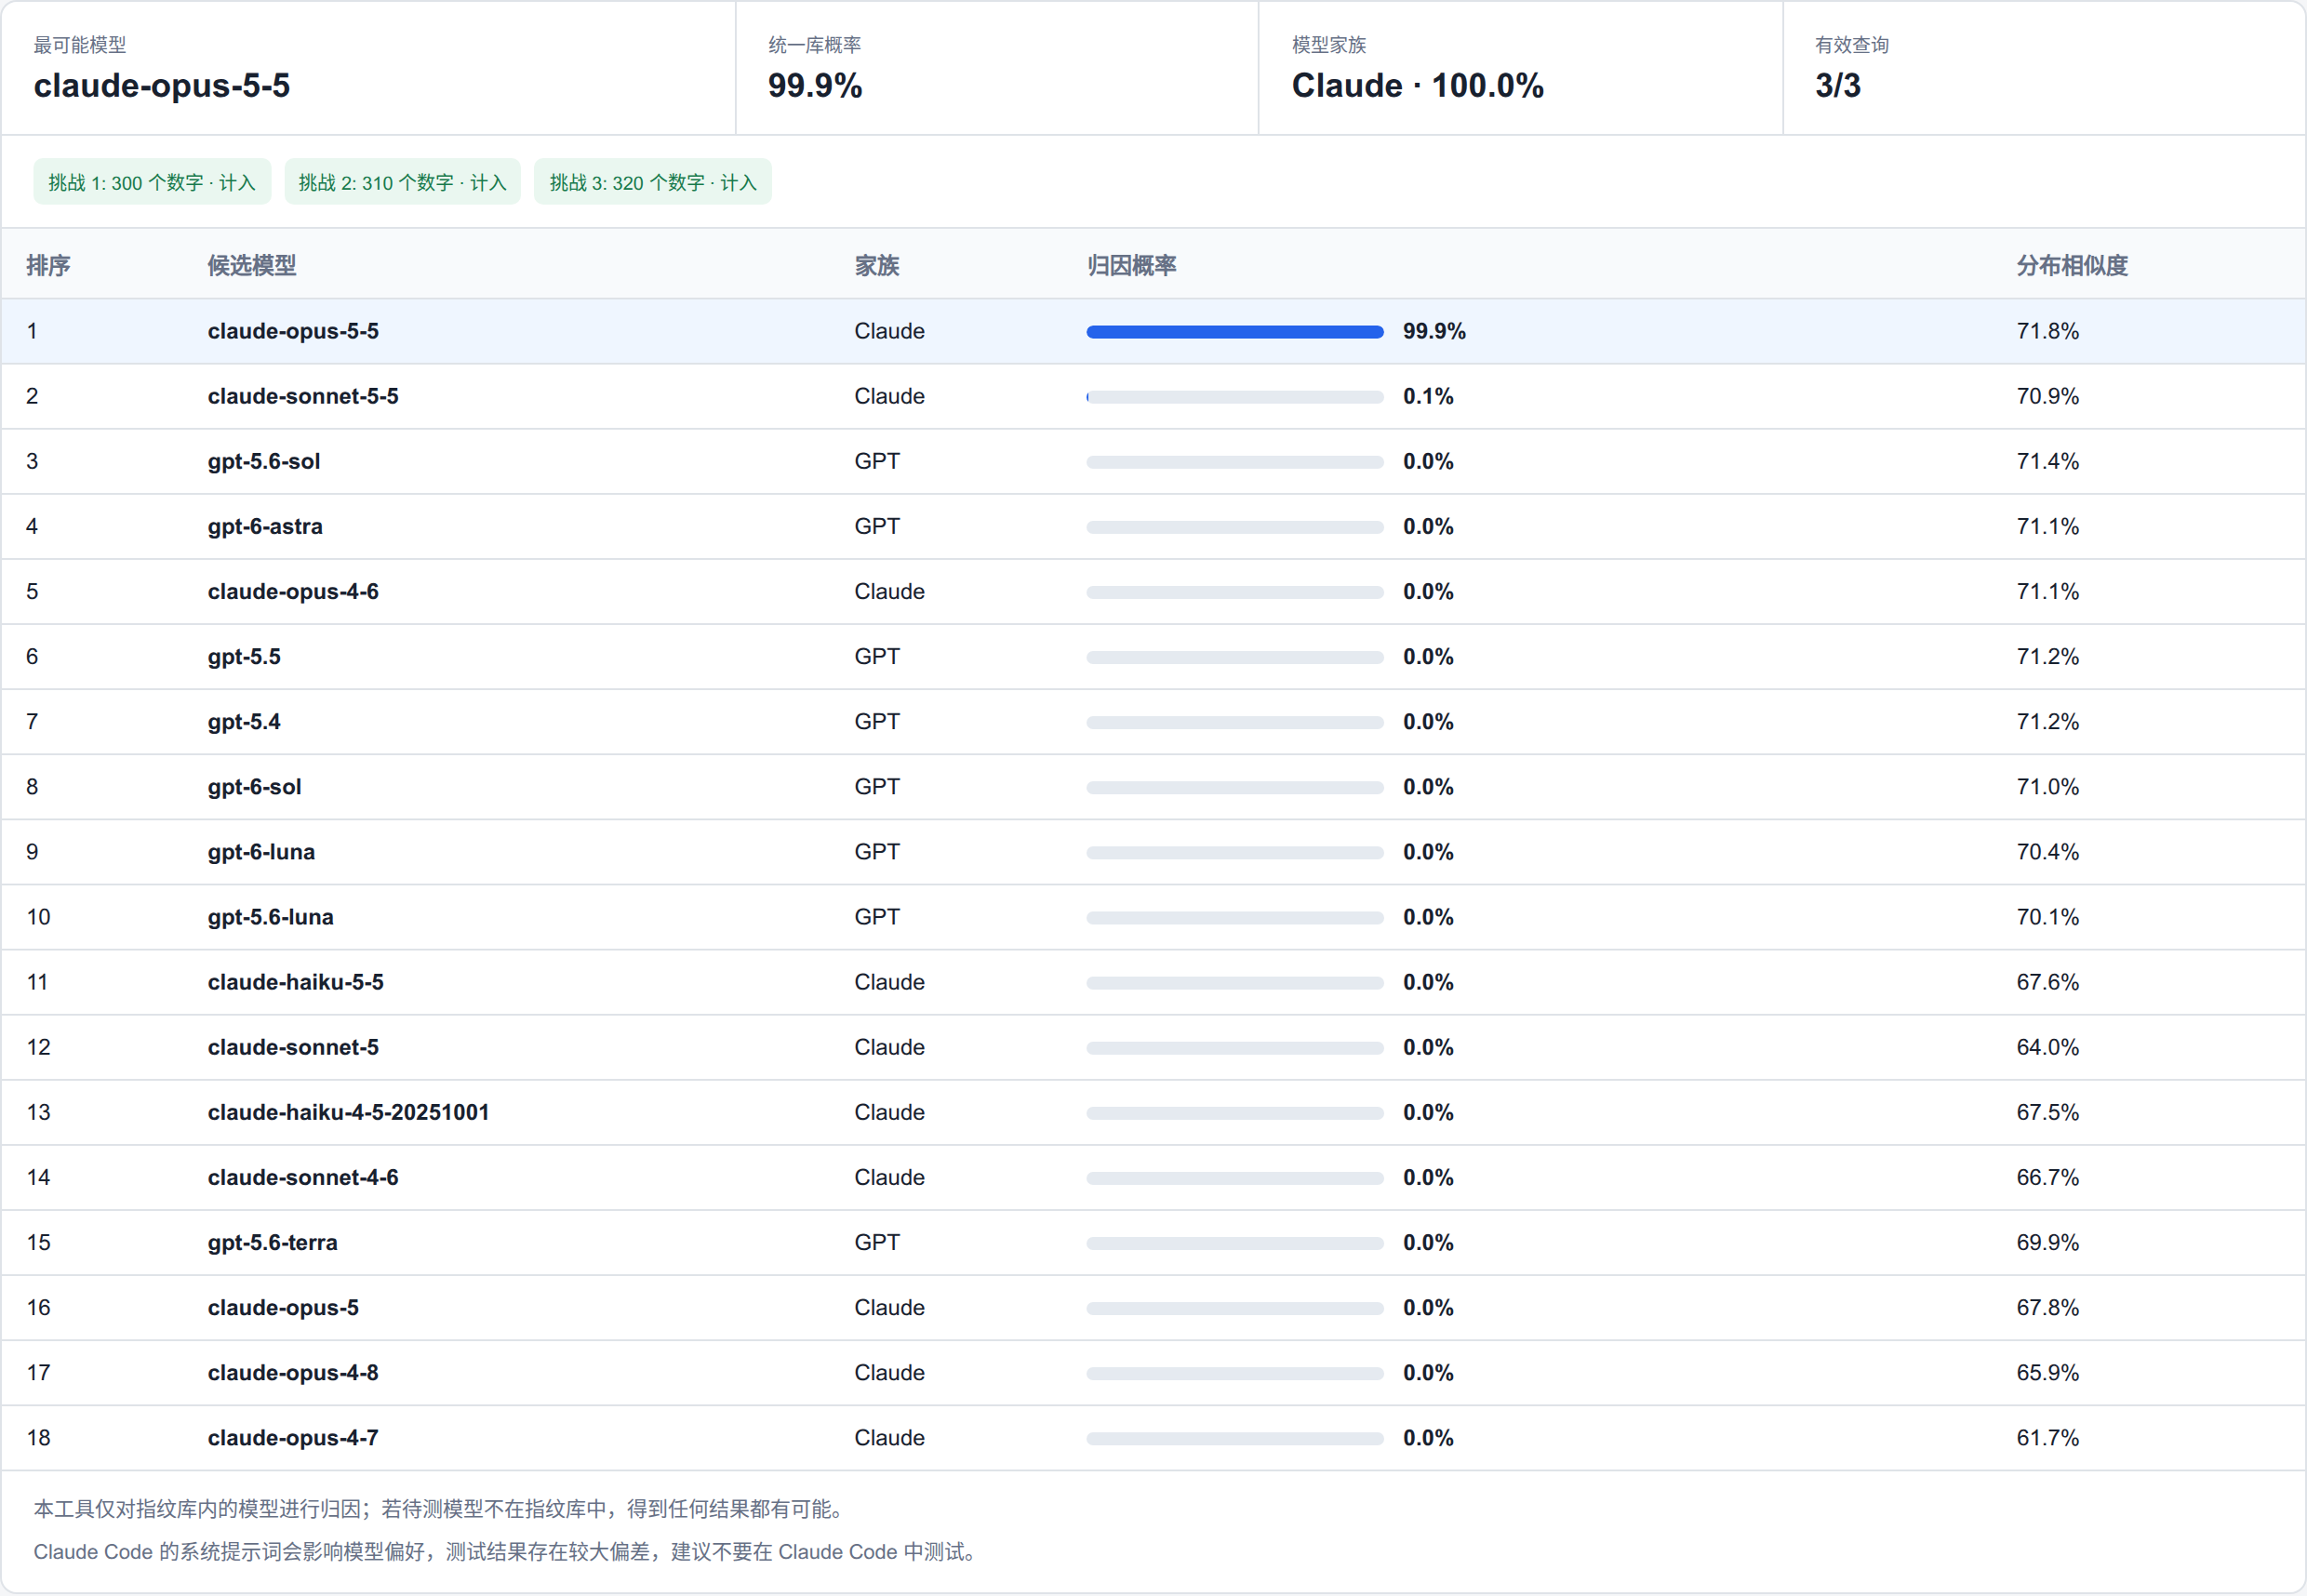
图:Python random 生成的数字在 ModelTrace 网页版上的归因结果
Python random 模块你也干了!它底层用的梅森旋转算法,明明是松本真和西村拓士 1998 年发表的,比 OpenAI 成立早 17 年,比 Claude Opus 5.5 发布早 28 年。按这两天某些人的鉴定逻辑,这叫什么?这叫超前部署、逆向蒸馏。
更邪门的还在后面。我随手敲了三个神秘数字:26, 32, 1。什么都不干,就把这三个数像复读机一样循环复制三百遍,塞进工具里。
结果出来了:99.88% 是 Claude Opus 5.5,Claude 家族 100.0%。
从南北朝数学家、宇宙常数、1998 年的随机数算法,到随手按出来的复读机数列,全在偷 OpenAI 和 Anthropic。人类正式进入大蒸馏时代,万物起源皆是硅谷两大家族。
停停停,这到底在搞什么鬼
先别急着给祖冲之发律师函。这整套把戏的源头,是 10 月 17 日 DeepSeek 更新了 V4.1 Flash 的 1017 版。
新模型上线不到一天,X 上就有人晒出一张 ModelTrace 的网页截图:ds-4.1-flash-1017 测出来 84.66% 是 gpt-6-astra,GPT 家族概率 90.71%。评论区瞬间高潮,有人宣布“换皮实锤”,有人阴阳怪气,仿佛抓到了连夜偷渡权重的铁证。
我也拿 DeepSeek 官方 API 的同一个 1017 版本,在同一个工具上测了一次。
结果呢?第一名变成了 gpt-5.6-sol(47.7%),第二名是 gpt-5.5(28.4%)。前一天还板上钉钉的 gpt-6-astra,连前三都没挤进去。
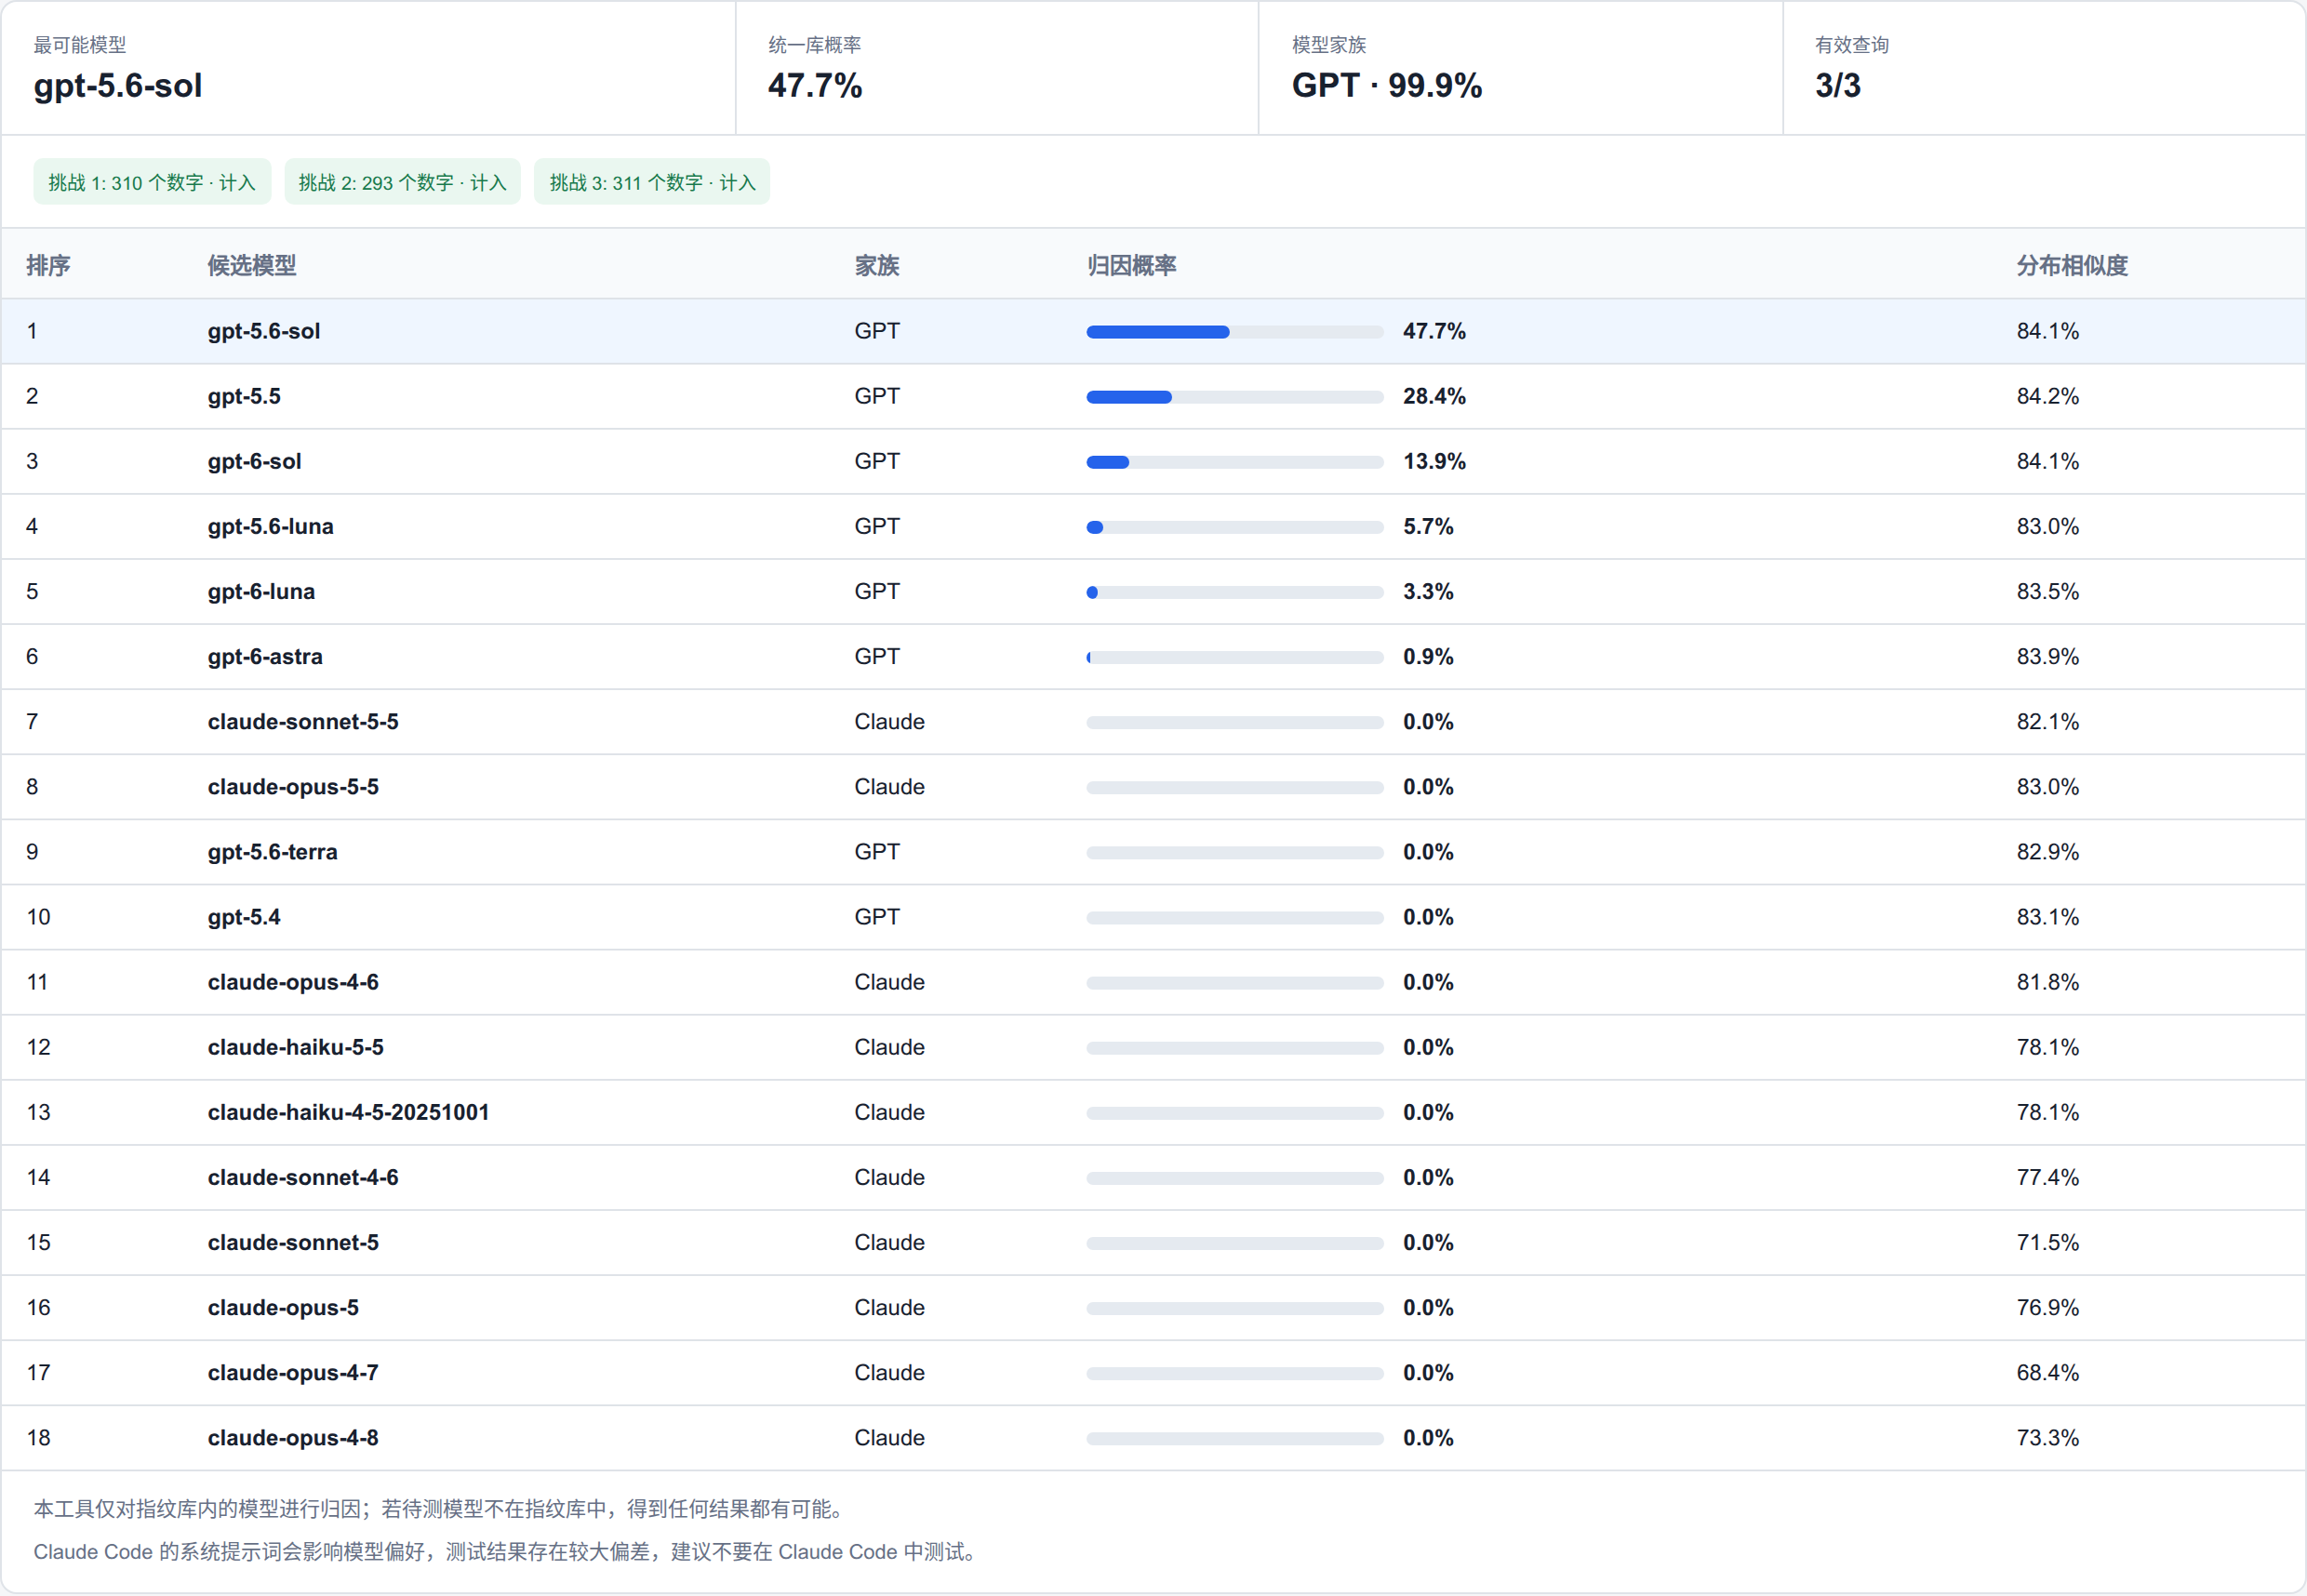
图:DeepSeek V4.1 Flash(官方 API)在 ModelTrace 网页版上的归因结果
为什么塞什么进去,测出来不是 GPT 就是 Claude?
因为这个工具的候选库里,总共就只有 8 个 GPT 模型和 10 个 Claude 模型。 没有 DeepSeek,没有 Gemini,没有千问,没有圆周率,也没有祖冲之。
这就是一道只有 A 和 B 两个选项的单选题。你把一只猫、一块砖头、一串乱码交上去,问它“这是 A 还是 B”,它的算法算完一圈,最后一步必做一次归一化,逼着所有选项的概率加起来等于 100%。它就算想说“我不认识”,答题卡上也没印 C 这个框。
更好笑的是,工具作者自己在 GitHub 的 README 里早就把话写死了:
结果是当前候选库内、均匀先验下的闭集概率。未收录模型仍会被归到最相似的现有候选。测试结果仅供参考,并非判断模型的决定性证据……若待测模型不在指纹库中,得到任何结果都是有可能的。
这个工具本来是给 API 中转站验货用的——你花钱买了个号称是 Claude Opus 5.5 的接口,怕奸商拿便宜的 Haiku 掺假糊弄你,用它发三道 1 到 355 的选数题比对一下分布。人家做的是验钞机,实锤党非要拿去给隔壁老王做亲子鉴定,截完图还极其精准地把底下那行免责说明裁掉。
那“自称 ChatGPT”总能实锤了吧?
看指纹这招实在兜不住,有人立刻端出第二条铁证:去掉系统提示词之后,直接问新模型“你是什么模型”,它会回答“我是 OpenAI 开发的 ChatGPT”。
今年 5 月底,Anthropic 自家旗舰 Claude Opus 4.8 刚上线的时候,国内外一堆开发者直接调官方 API、不加系统提示词问它“你是谁”。它张嘴就来:“我是通义千问(Qwen),由阿里巴巴开发。”再问一遍,改口了:“我是 DeepSeek,由深度求索开发。”
原因根本没那么玄乎:在没有系统提示词、也没专门拿“自我认知”数据硬训过的情况下,没有任何一个大模型知道自己叫什么名字。
模型的名字是训练完之后,产品经理开会起出来的。权重里从来没有一张写着“我叫某某某”的身份证。一旦走裸 API 把系统提示拿掉,模型只能顺着训练语料里最常见的问答句式往下接话:英文互联网上“我是 ChatGPT”最多,中文互联网上“我是千问”“我是 DeepSeek”遍地都是,摸到哪句算哪句。
顺便讲讲:到底什么才叫蒸馏
平时大家嘴里的“用大模型训小模型”,按做法其实分三档:
- 最笨的办法:直接对答案的概率分布。 也就是传统意义上的知识蒸馏——拿老师模型输出每个词的完整概率(logits)当标准答案,硬压着学生模型去拟合。
- 稍微好一点的办法:让它吐一批成品答案,拿去训练。 本质上是合成数据。但如果只是把别人吐出来的最终结果拿来当语料喂进去,连它中间怎么试错、怎么权衡都不知道,那学到的顶多是说话的口气和排版格式。
- 真正最高级的用法:拿它搭环境、做裁判、拆解中间过程。 你用强模型去构建高难度的训练环境,或者参考它中间是怎么设计方案、怎么一步步推演的,用它当脚手架去训练自己的模型。
说到底,真正有价值的蒸馏,必须拿到它的中间推理与设计过程。在完全不了解大模型技术的情况下,拿着自己都没读懂、用法完全错误的工具到处扣帽子——下次再端着截图出来鉴爹之前,哪怕稍微往下滑两厘米,把人家网页底下的说明书读完呢?
看视频版 实锤!祖冲之蒸馏了 Claude,而圆周率蒸馏了 GPT